 LiveSub
一律 1 秒の限界。生字幕でローカル翻訳を使い続けるための、文の長さに比例した予算と再試行
公開日: 2026-11-15
パソコンの Chrome / Edge で使えます(Firefox はマイク・音の入力から。Firefox 版は YouTube・Twitch。スマートフォンでは使えません)。対応は英語⇄日本語のみです。
ブラウザの中で翻訳モデルを動かすサービスは、同じ壁にぶつかります。 端末の GPU はばらばら、文の長さはばらばら、モデルは大きくて取得に時間がかかり、その間も画面を止めることはできません。
この記事は、LiveSub(ブラウザのタブの音声をその場で字幕と翻訳にするサービス)が、ローカル翻訳の「遅いから戻す」判定を本番の数字から組み直した記録です。 LiveSub は、ブラウザで見るライブ配信に特化しています。 字幕を止めないこと、話の山と谷に合わせて判定することなど、この記事の組み立てはすべて生配信を前提にしています。 式は形だけを書きます。係数は、自分の利用者で測って決めるものだからです。
1. 問題
1.1 2 つのエンジンで字幕を止めない
LiveSub の翻訳は 2 つのエンジンで動いています。 ブラウザに入っている翻訳(Chrome の端末内翻訳)が先に字幕を出し、GPU のある端末では、より自然な訳を出すローカルの翻訳モデル(PLaMo 3 Translate)を裏で読み込みます。 準備ができたら、文の切れ目で切り替えます。 ローカルの翻訳モデルは、株式会社Preferred Networks の PLaMo 3 Translate 0.8B です(Built with PLaMo)。
切り替えたあとも、原文の字幕はすぐに出ます。 訳は、先の翻訳の訳とローカル翻訳の訳を同時に始め、ローカル翻訳が予算に入ればその訳を、間に合わなければ先の翻訳の訳を出します(3.1 の図 4)。 前の文をまだ訳している間に来た文は、待たずに先の翻訳の訳を出します。 こうして、どの分岐でも字幕は止まりません。
1.2 軽いものから始め、端末の力に合わせて上げる
2 つのエンジンは、もっと大きな段の一部です。 LiveSub は、初めて開いた人をいちばん待たせない形から始め、端末の力に合わせて段を上げます。 生配信は待ってくれないので、まず字幕を出し、良くするのはそのあとです。
| 段 | 聞き取り | 翻訳 |
|---|---|---|
| 1. 初めての 1 回 | 軽量(英語 約 120MB・日本語 約 206MB) | ブラウザの端末内翻訳 |
| 2. 標準 | 標準(英語 約 400MB・日本語 約 670MB) | ブラウザの端末内翻訳 |
| 3. GPU の力が足りれば | 標準(GPU で動いている) | ローカル翻訳(PLaMo 3 Translate、約 570MB) |
- 1 → 2: 標準の聞き取りは、軽量で字幕を出している間に裏で取って端末にしまい、字幕を止めているときに差し替えます。2 回目からは標準で始まります。手元の測定(50Mbps の回線)では、初めての字幕までが 94.7 秒から 41 秒になりました
- 2 → 3: 聞き取りが GPU で動いていて、GPU が 16 ビットの計算に対応している端末だけで、ローカル翻訳を裏で読み込みます。準備ができたら、文の切れ目で切り替えます。軽量で始めた回は、標準の聞き取りを取り終えてからローカル翻訳を取り始めます
- 下がる道: 聞き取りが追いつかない端末では、より軽い聞き取りに替えます。ローカル翻訳が間に合わない端末では、ブラウザの端末内翻訳に戻します
どの段でも、字幕は止まりません。 この記事が扱うのは、3 段目の「上げたあと、いつ下げて、いつ戻るか」の判定です。
1.3 止まらない代わりに、静かに失う
止まらない代わりに、判定を誤ると利用者は静かに良い翻訳を失います。 字幕は出続けているので、利用者には「少し訳が固くなった」としか見えません。 運営の側も、戻した回数を数えていなければ気づきません。
出発点の実測はこうでした(図 1)。
- 翻訳を使った訪問のうち、ローカル翻訳を終わりまで使えたのは約 3 分の 1
- 戻した訪問の多くは、端末の故障や極端に遅い GPU ではなく、日常の場面で起きていた
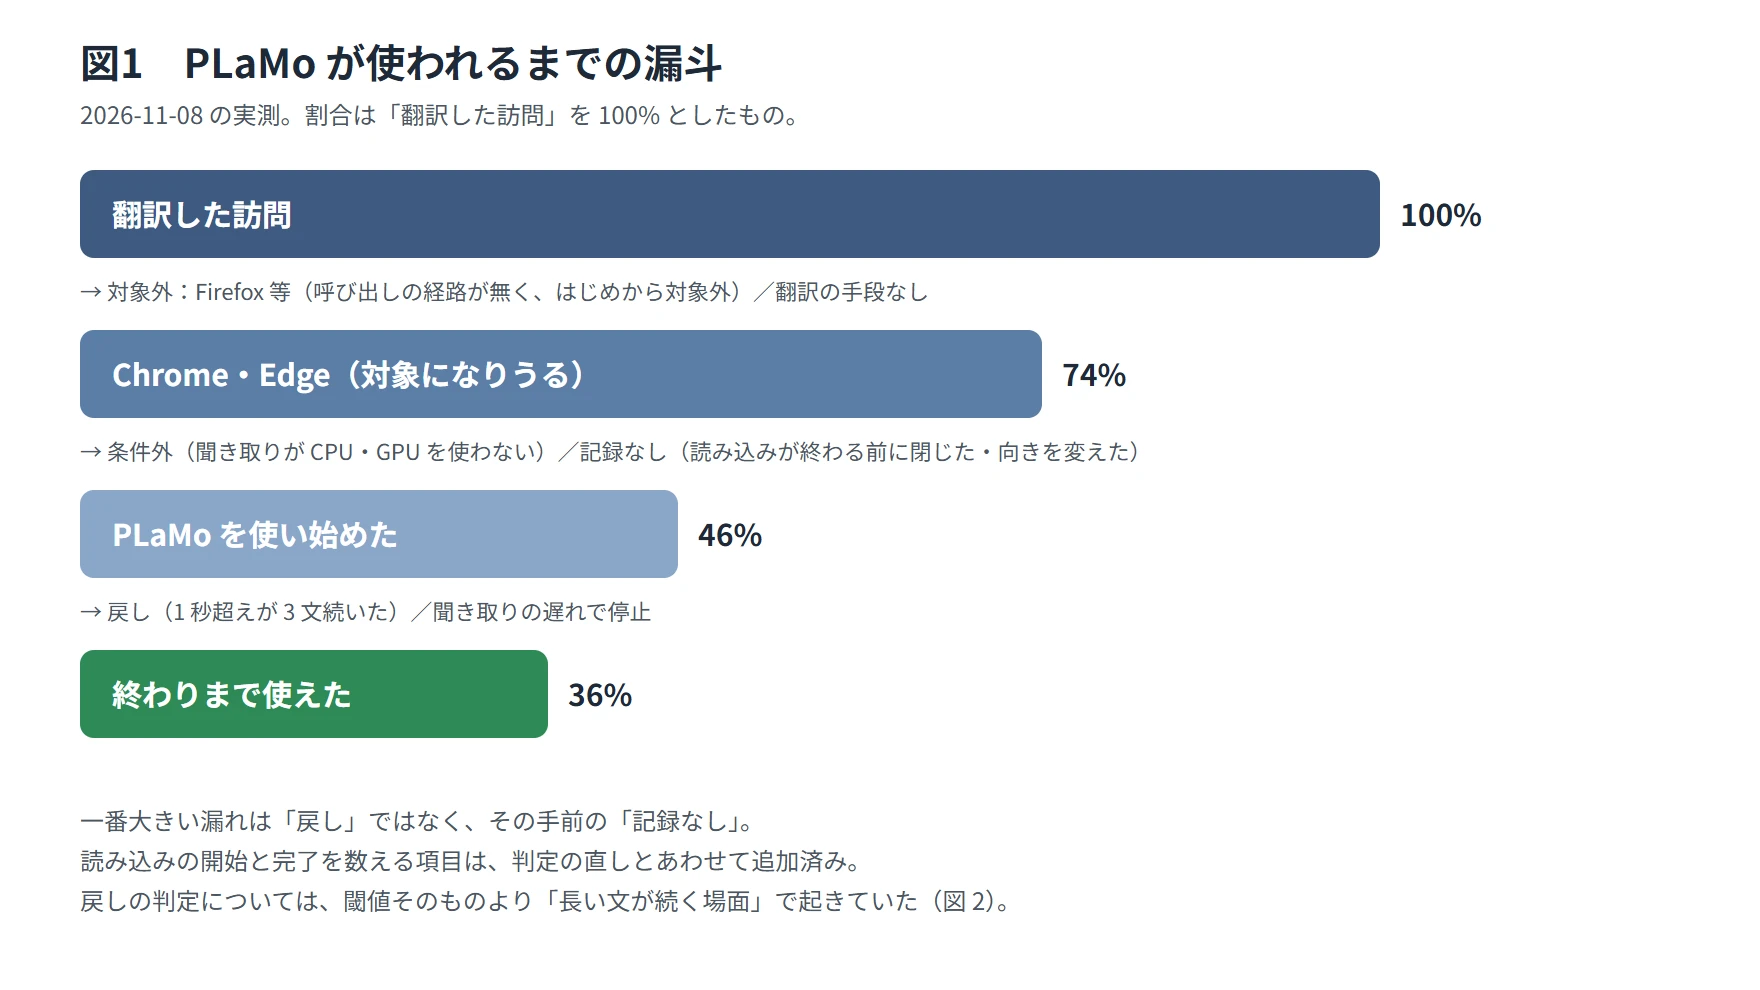
いちばん大きな漏れは「戻し」ではなく、その手前の「読み込みが終わる前に閉じた」訪問です。 これは取得の速さの問題で、判定とは別に直します。 この記事が扱うのは最後の段、戻したあとに戻れない判定です。
2. 従来方式(一律の時間)の限界
2.1 時間は文の長さに比例する
最初の判定は単純でした。 1 文の訳が一定の時間(1 秒)を超えたらその文は先の翻訳の訳を出し、それが続いたらその回はローカル翻訳をやめる、というものです。
問題は、推論の時間が文の長さに比例することです。 言語モデルの推論は、入力をまとめて処理する段(prefill)と、訳を 1 語(トークン)ずつ出す段(decode)に分かれます。 1 文の時間は、入力の処理にかかる固定の分と、訳の 1 語ごとにかかる分の和になります。 待ち時間が一律だと、長い文ほど「遅い」と数えられる偏りが出ます(図 2)。
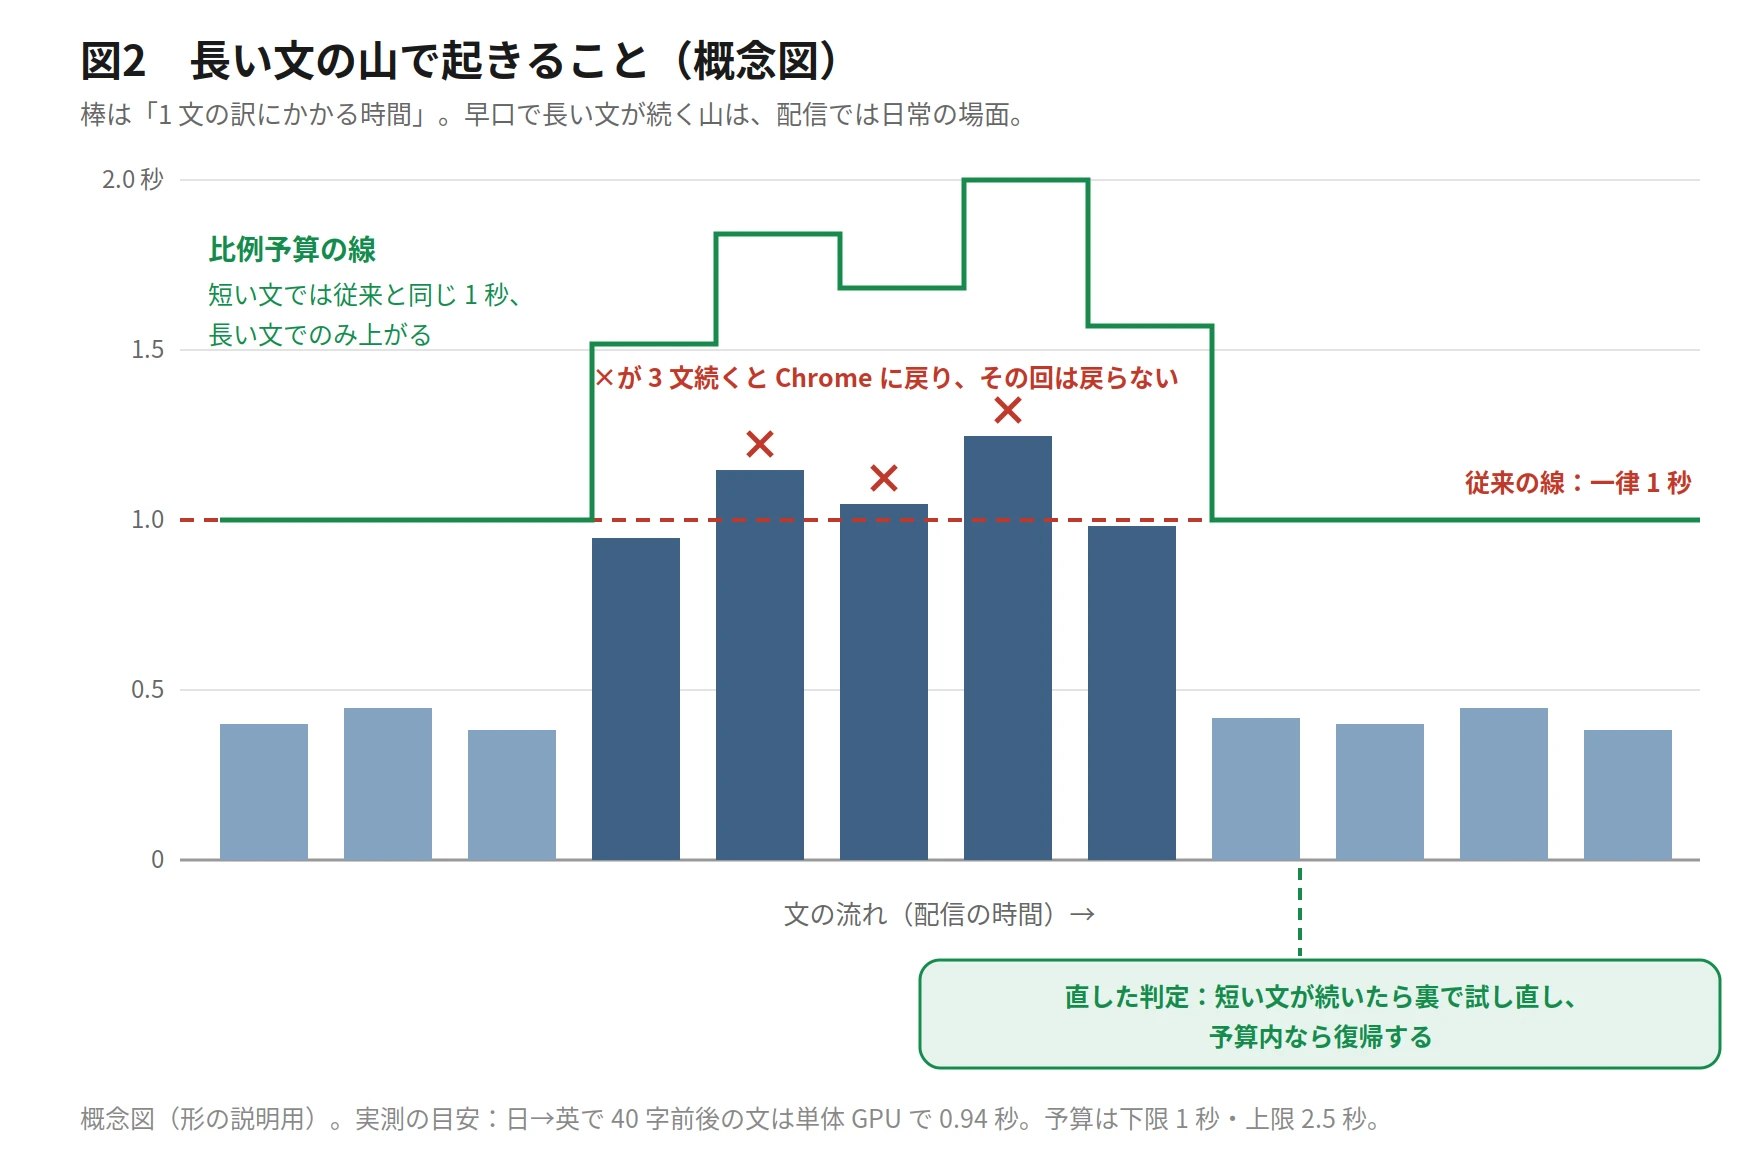
実測では、一律 1 秒の線に対して、40 字前後の日本語の文は単体の GPU でもその 9 割超を使いました。 内蔵の GPU では、ふだんの長さの文で線を越えます。 日本語から英語への翻訳は、原文 1 字あたりの訳の語数が英語から日本語の数倍になるので、同じ字数でも長くかかります。 つまり「遅い端末」ではなく「長い文」が、判定に引っかかっていました。
2.2 連続の回数で決めると、山で切れる
判定は「超えるのが続いたら戻す」の形でした。 生配信には「早口で長い文が続く山」が日常にあります。 話が盛り上がると、文は長くなり、間は短くなります。 山のたびに切り替わり、その回は二度と戻らない設計だと、山の多い配信ほど良い翻訳が届きません。
連続の回数で決める方法は、偶然の連敗と本当の遅さを区別できません。 これは分散システムでサーキットブレーカーを設計するときに知られている問題と同じです。 判定が厳しいのではなく、判定が測っているものが違っていました。
3. 提案手法
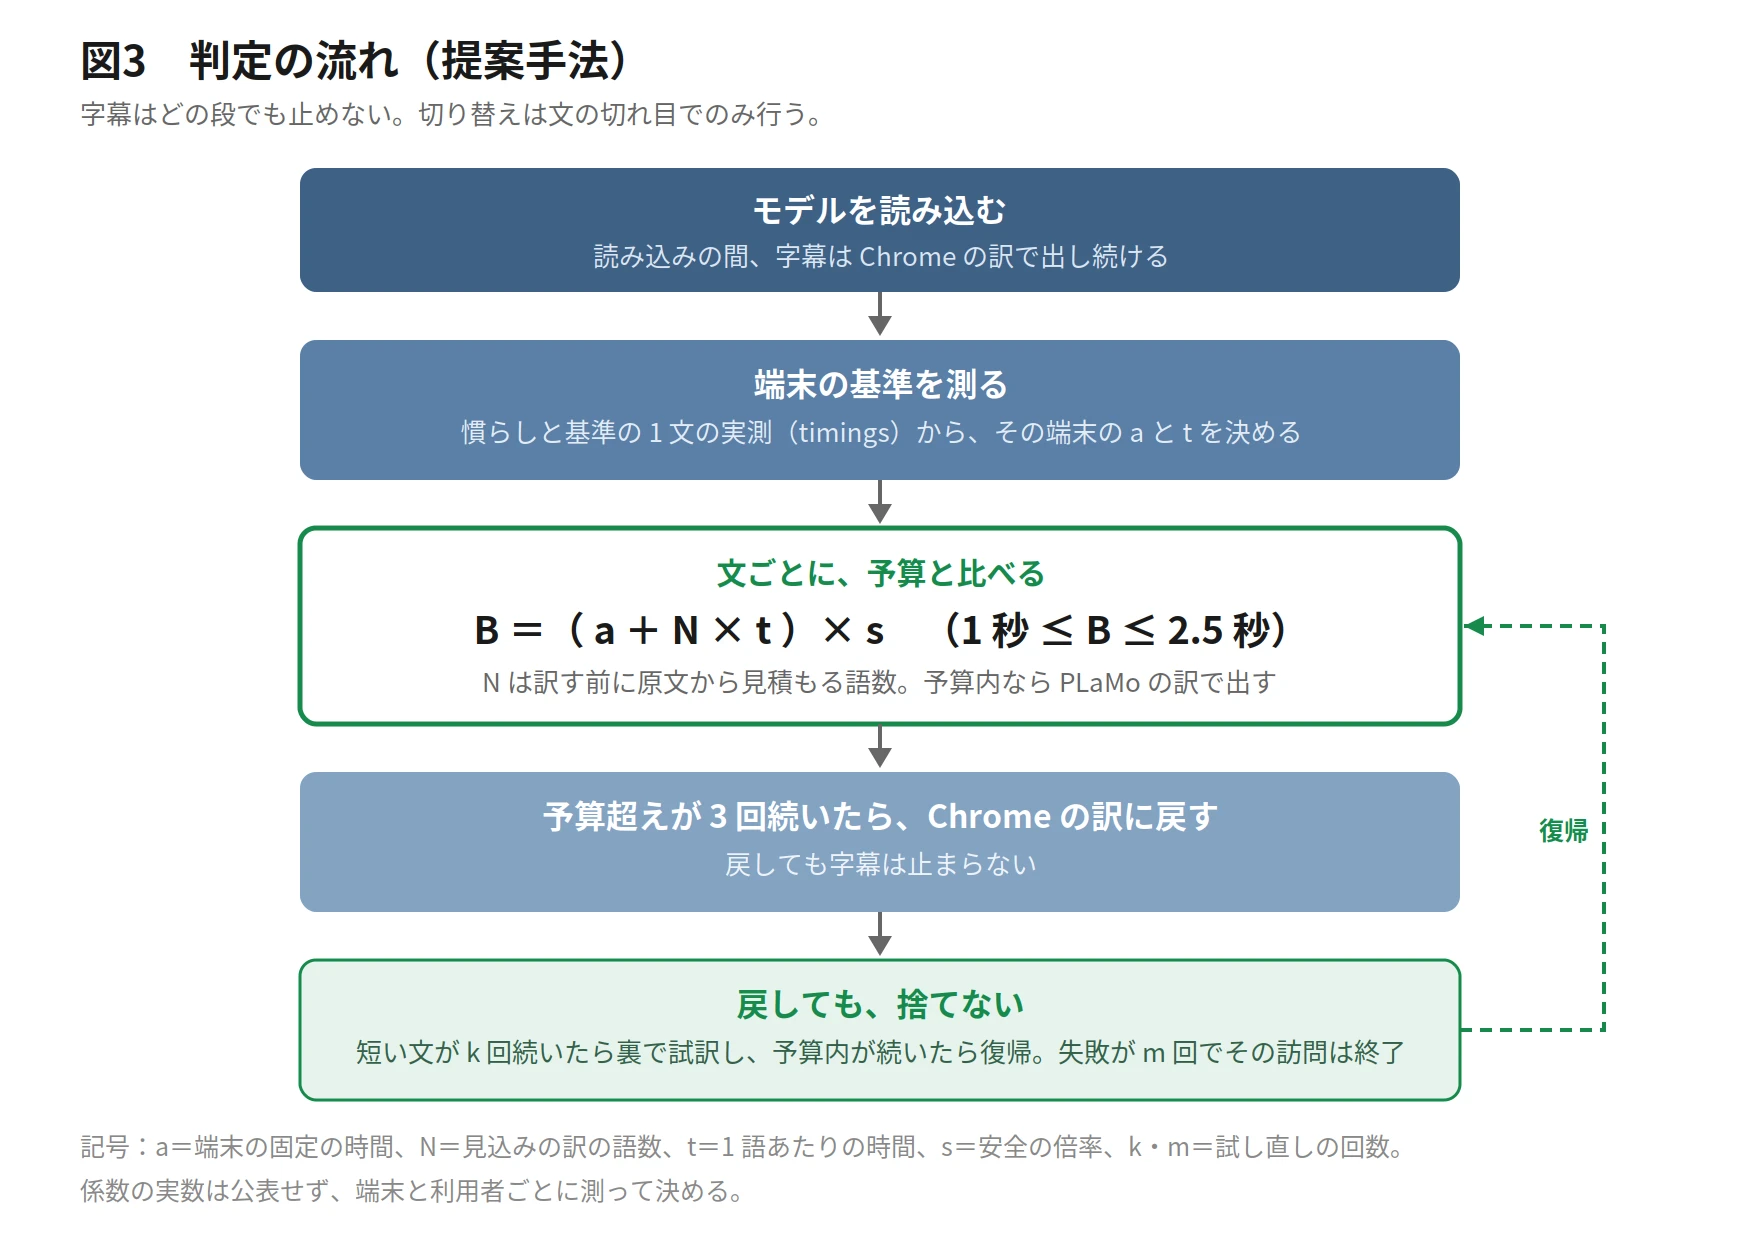
判定で直したのは 3 つ(3.1〜3.3)です。いずれも「字幕は止めない」「切り替えは文の切れ目だけ」という制約の中で動きます(図 3)。 あわせて、判定を支える測る項目(3.4)と、名前の扱い(3.5)も書きます。
3.1 比例予算
1 文の訳を待つ時間(予算 B)を、文ごとに決めます。
B = ( a + N × t ) × s (1 秒 ≤ B ≤ 2.5 秒)
- N: 訳の語数の見込み。訳す前に決めなければ意味がないので、原文の字数から言語ごとの換算率で見積もる
- t: その端末で訳の 1 語にかかる時間
- a: その端末で入力の処理にかかる固定の時間
- s: 安全の倍率
- 下限の 1 秒は従来の線と同じ(短い文でも予算を下回らせない)。上限の 2.5 秒は、訳が原文から離れすぎないための線
短い文の予算は従来の線と同じで、長い文だけが長さのぶん延びます。 「遅い」の定義が、文の長さと独立になります。
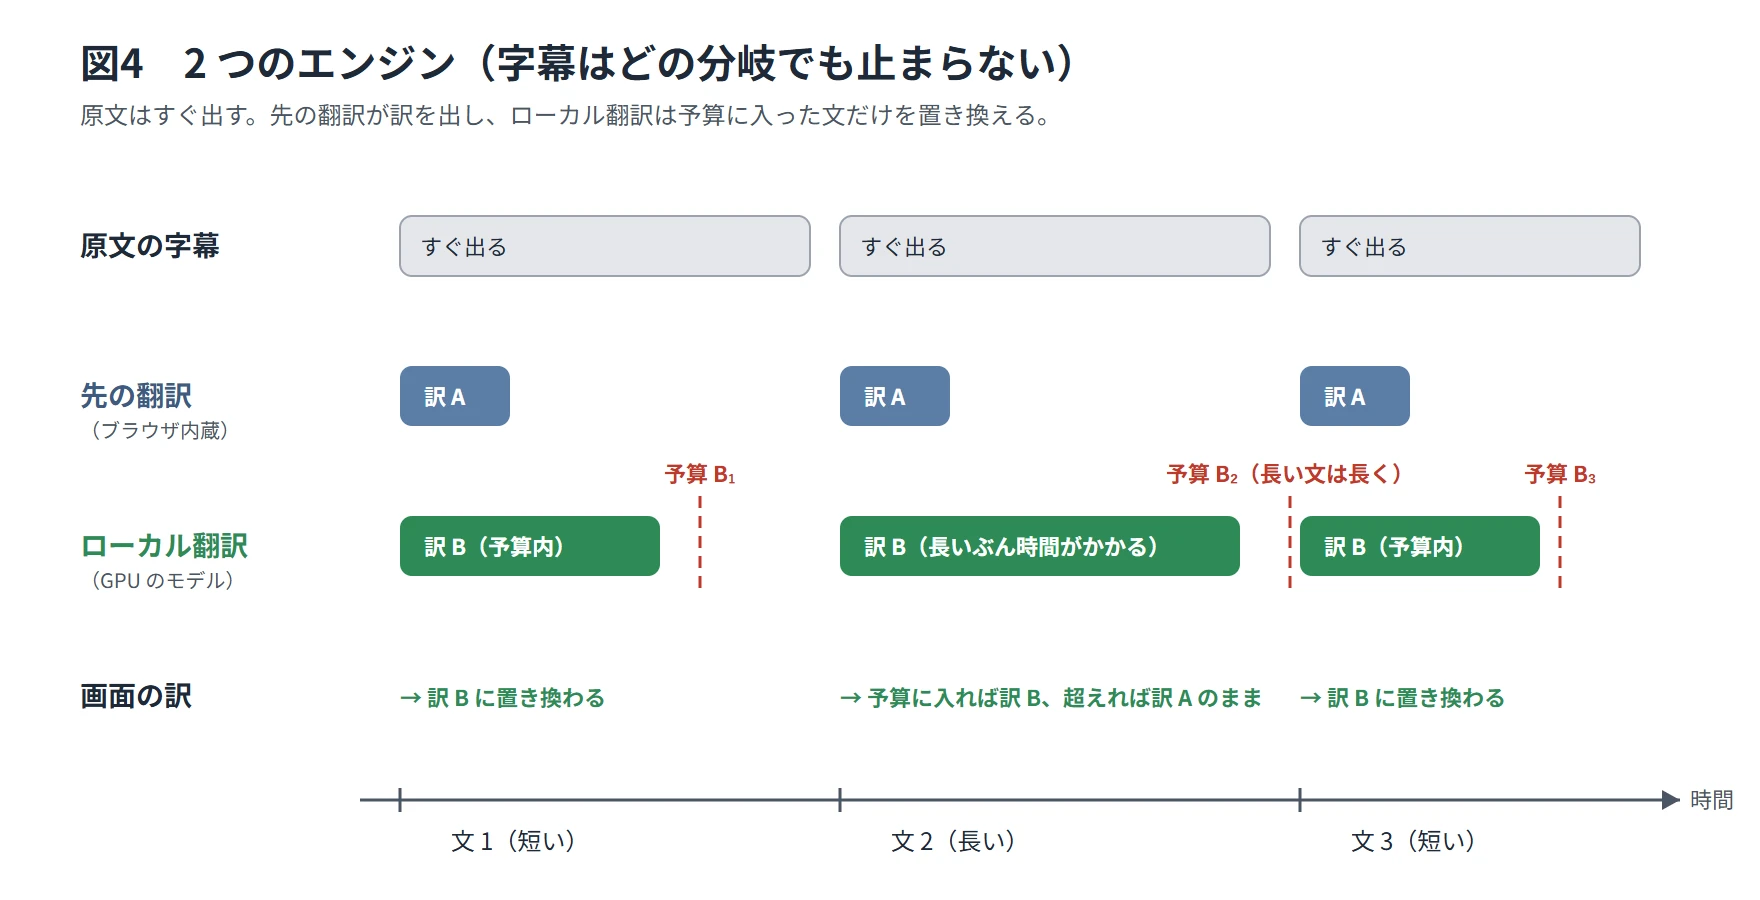
上限の 2.5 秒は、画面の都合から決めます。 字幕は次の文が来ると入れ替わるので、訳がそれより遅れて届いても出す場所がありません。 字幕を出しておく時間は原文の長さに応じて延びるので、予算の上限もその範囲に収めます。
なぜ訳の語数を「訳す前に」見積もるのか。 予算は訳を始める時点で決まっていないと、間に合わなかったときに先の翻訳の訳を出す判断ができないからです。 訳し終わってから「遅かった」と分かっても、その文の字幕はもう出ています。 原文の字数からの見積もりは粗いですが、長い文と短い文を分けるには足ります。
3.2 端末ごとの較正
a と t は全端末一律の係数にしません。 モデルを読み込んだ直後に慣らしの 1 文を訳し、続けて基準の 1 文を訳して、その実測(入力の時間・出力の語数と時間)からその端末・その訪問の a と t を決めます。
慣らしの 1 文を先に置くのは、GPU の 1 文目には計算の準備(シェーダーのコンパイルなど)の時間が乗るからです。 基準の 1 文は、字幕の文としてふつうの長さにして、1 語あたりの時間が安定して取れるようにします。
GPU の混み具合は訪問ごとに違うので、保存はせず毎回測ります。測り直しは 1 秒かかりません。 実測が取れなかった端末には、単体の GPU を少し上回る既定の値を使います。 速い端末に厳しくするより、遅い端末に甘くするほうが、字幕の見え方としては安全だからです。
較正には副産物があります。 基準の 1 文の「訳 1 語あたりの時間」を端末の速さの帯(速い・中くらい・遅い)として集計すると、使っている端末がどの帯にどれだけいるかが分かります。 戻した訪問は GPU の作り手ごとに数えているので、帯の分布と並べると、戻しが遅い端末に寄っているのか、速い端末でも起きているのかの見当がつきます。
3.3 再試行(戻る道)
予算超えが 3 回続いたら先の翻訳に戻しますが、戻したあとも、モデルは捨てません(図 3 の最後の段)。 短い文が k 文続いたら、次の文を裏でローカル翻訳にも訳させます。字幕は先の翻訳の訳のまま出します。 裏の訳が予算に入るのが続いたら、文の切れ目でローカル翻訳に戻ります。 予算を超えた試行が m 回に達したら、その訪問ではやめて GPU から外します。 短い文が続かない話し方のために、時間による予備の合図も置きます。
試行を裏で行うのは、試しに失敗したときに利用者を待たせないためです。 字幕は先の翻訳の訳で出ているので、裏の訳が遅くても画面は変わりません。 戻るときに「予算に入るのが続いたら」と、続けて入ることを求めるのは、境目の端末で表示元が行ったり来たりしないためです。 戻すより戻るほうを少し厳しくする、いわゆるヒステリシスです。
短い文を合図にするのは、短い文のほうが試行が安く、成功しやすく、失敗しても無駄が小さいからです。 話の谷(短い相づちが続く所)で試し、山(長い文が続く所)では試しません。 配信の話のリズムを、そのまま判定の合図に使っています。
この形は、分散システムのサーキットブレーカー(閉・開・半開)の転用です。 新しいのは部品ではなく、「生字幕・ブラウザ・2 つのエンジン」という条件での組み立てと、本番で測って係数を置いたことです。
3.4 測る
判定を直す前に、測る項目を足しました。 文ごとには、入力と出力の語数と、それぞれにかかった時間を数えます。 訪問ごとには、読み込みを始めたか、断片を取りに行ったか、戻したか、戻れたか、やめたか、端末の速さの帯を数えます。 推論エンジンは語数と時間を返してくれるので、足すのは集計の項目だけです。
測らずに閾値を動かしても、良くなったかどうかが分かりません。 「遅い文」の数と「戻した訪問」の数を別に数えると、閾値が厳しいのか、端末が遅いのかが分かれます。
3.5 用語集(名前を、聞き取りから訳まで通す)
配信でいちばん崩れやすいのは、人の名前、ゲームの用語、商品名といった決まった名前です。 聞き取りは毎回違う綴りで出し、翻訳はその名前をふつうの単語として訳してしまいます。 LiveSub では、利用者が書いた語を、聞き取りと翻訳の両方に通します。
- 今日のキーワード(3 語まで): その配信で何度も出る名前を、標準の聞き取りにそのまま渡します。聞き間違いそのものを減らします。端末には残しません
- 用語集(1 行に 1 語): 聞き取った文字を、登録した表記に直します。関係の無い語を書き換えないよう、似ている度合いだけでなく、先頭の文字と長さの差も条件にしています。「たなか = Tanaka」と書くと、訳に出す名前の書き方も決められます
- 用途別のパック: 配信・ゲーム・アニメ・会議などでよく出る語を、まとめて入れられます。ふだんの文を 1 文も書き換えない語だけを選んでいます
- 用語集を作るページ: 用語集の欄の「用語集を自分で作る(別のタブ)」から開きます。語ごとに「元の言葉・種類・翻訳で出したい言葉」を選ぶだけで行ができ、記号は打たなくて済みます。「本物の文で試す」で、実際の翻訳で訳が良くなるかを確かめてから、「まとめてファイルで出す」で 1 つのテキストファイルにできます
- 配る: 作った用語集は、ゲームの MOD のように、同じ配信を見る人に配れます。受け取った人は、用語集の「ファイルから追加」で入れるだけです。ファイルは端末の中だけで作って読み、LiveSub のサーバーには送りません(作り方は 字幕の用語集の作り方と配り方)
名前を訳に通す流れは 3 段です。
- まず名前をそのままにして訳す。決めた表記がもう訳に出ていれば、その訳を使う(文が自然なまま)
- 出ていなければ、ローカル翻訳が使えるときは、モデルの用語集の枠(その文に当たった名前の組だけ)を付けて訳し直す。この訳も 3.1 の予算の中で待ち、間に合わなければ捨てる
- それでも出なければ、名前に印を付けて訳し、訳の中の印を決めた表記に戻す
手元の 47 文の比べでは、2 段目を入れても、指定どおりに名前が出た文は 46 文のまま変わりませんでした。 文の自然さは 9 文で良くなり、2 文で悪くなりました(読んで判断したのは 1 人)。 たとえば、印の方式の “I got flanking ed again” が、枠では “I got flanked again” になりました(どちらも PLaMo 3 Translate が出した訳です)。
用語集の枠も比例予算の中で動くので、「字幕を待たせない」という制約はここでも同じです。
4. 実測
出す前(2026-11-08、訪問の単位。図 1):
- 翻訳を使った訪問のうち、ローカル翻訳を終わりまで使えたのは 36%
- ローカル翻訳を使い始めた訪問のうち、戻したのは 20%
- 戻した端末は、確かめられた範囲では内蔵の GPU で、戻すまでの回数はちょうど最小の 3 文でした
出したあと(2026-11-09 夕方の版から。丸 1 日がそろう 11/10〜11/14 の 5 日):
| 出す前(11/8) | 出したあと(11/10〜11/14) | |
|---|---|---|
| 対象になりうる(先の翻訳が Chrome の端末内翻訳) | 74% | 80% |
| ローカル翻訳を使い始めた | 46% | 40% |
| 終わりまで使えた | 36% | 34%(日ごとは 32〜38%) |
| 使い始めた訪問のうち、戻した | 20% | 14% |
| 戻した訪問のうち、戻れた | 戻る道が無かった | 約 3 分の 1 |
| 遅い文(予算超え ÷ 訳した文) | 数えていなかった | 1.3%(381 / 30,081 文) |
上の 3 行は、翻訳を使った訪問を 100% とした割合です(図 1 と同じ)。 数えているのは訪問(ページを開いて字幕を始めた 1 回)で、人ではありません。 「終わりまで使えた」は、使い始めた訪問から、戻した訪問と字幕の遅れでやめた訪問を引いたものです。出す前と比べるため、戻れた訪問もここには足していません。
戻した割合は 20% から 14% に下がり、遅い文は訳した文の 1.3% でした。 一方で、終わりまで使えた割合は 36% から 34% で、ほぼ横ばいです。 判定の直しが効くのは漏斗の最後の段だけで、それより前の段(使い始めるまで)の漏れが大きいままだからです(図 1)。
戻した訪問は、GPU の作り手で分けると偏っていました。
| 端末の GPU | 使い始めた訪問に占める割合 | そのうち戻した割合 |
|---|---|---|
| NVIDIA | 43% | 3% |
| Intel(多くは内蔵) | 29% | 32% |
| AMD | 18% | 19% |
| Apple | 9% | 0% |
戻した訪問の約 3 分の 2 は Intel でした。 比例予算は「速い端末が長い文で戻る」を減らすための直しで、単体の GPU が多い NVIDIA で戻したのは 3% でした。
端末の速さの帯(基準の 1 文の、訳 1 語あたりの時間で 3 区分)は、使い始めた訪問のうち、速い 56%・中くらい 22%・遅い 22% でした。 戻した訪問は帯ごとには数えておらず、GPU の作り手で数えています。
本番の 1 文は、平均で入力 38.3 語・訳 9.2 語、時間は 507 ミリ秒でした(訳した 30,081 文の合計から)。 前の文をまだ訳している間に来て、待たずに先の翻訳の訳を出した文は、数え始めた 11/12 から 11/14 で、訳した文の 1.4%(310 / 21,605 文)でした。
途中で、入力の組み立てを変えています(11/11 の朝から、前の 1 文も渡すようにした)。 1 文の入力は約 23 語から約 43 語に増えましたが、遅い文は 11/10 の 0.8%(40 / 5,227 文)から 11/12〜11/14 の 1.3%(288 / 21,605 文)で、戻した割合は 14% から 16% でした。 入力が倍近くになっても、予算超えは訳した文の 1〜2% にとどまりました。
文ごとの語数と時間を数え始めてからの累計は、次のとおりです(2026-11-09 の版を出してから 11/14 まで、延べ数百の訪問)。
| 累計 | |
|---|---|
| ローカル翻訳が訳した文 | 30,346 文 |
| 入力の語数 | 1,157,385 語 |
| 訳の語数 | 280,687 語 |
| 訳にかかった時間 | 4 時間 19 分(入力の処理 2 時間 26 分・訳を出す 1 時間 53 分) |
語はモデルが数える単位(トークン)です。文字数は記録していません。原文の字数は、訳す前に予算を見積もるときにだけ使います。 すべての文で「長さ」と「時間」を同じ文の組として持っていることが、この判定の土台です。 時間だけでは、遅い端末と長い文を区別できないからです。 訳した文は 3 万を超えていて、文ごとの長さと時間の関係を見るには十分な量がたまっています。
この数字を見て、閾値と係数は動かさないことにしました(2026-11-15)。
出す前に、手元で 3 つの場面を確かめました。音は鳴らさず、合成音声をページの中で流しています。
| 場面 | 結果 |
|---|---|
| 40 字前後の日本語の文が短い間で続く(単体の GPU) | 予算超え 0、戻し 0 |
| 遅い端末(1 文ごとに人工的に遅らせる) | 続けて超えた所で戻し、試行がすべて超えて、その訪問ではやめた。字幕は先の翻訳で止まらず続いた |
| 戻した直後に速さが戻る端末 | 短い文の試行が続けて入り、ローカル翻訳に戻った |
注意: 「遅い文」の集計の意味が、この版を境に「一律の線を超えた」から「予算を超えた」に変わります。境の前後は分けて読みます。
5. 考察
5.1 なぜ配信で効くか
LiveSub のいちばんの強みは、ブラウザでのライブ配信に特化していることです。 録画の動画なら止めて待てますが、生配信は待ってくれません。 だから「字幕は止めない」を最初の制約に置き、その中で良い翻訳をどれだけ届けられるかを測ってきました。
配信の音声は、無音が来ない代わりに声が BGM に埋まり、話には山と谷のリズムがあります。 山では長い文が続き、谷では短い相づちが続きます。 従来方式は山で切れ、二度と戻りませんでした。 比例予算は山を越え、再試行は谷で戻ります。 このリズム自体を再試行の合図に使うのが、生字幕向きの置き方でした。
5.2 やらなかったこと
- 連続の回数を「直近の何文かのうち何割か」に変えること。比例予算で「遅い」の定義を直せば、連続の回数のままでも本当に遅い端末だけに当たると見て、数字を見てから決めることにしました
- モデルを軽い量子化に替えること。ブラウザの GPU では量子化が速さに効くとは限らないという報告があり、実機で測ってからにしました
- 対象外のブラウザへの拡大。先の翻訳が無いブラウザでは「字幕を止めない」の前提が成り立ちません
5.3 一般化
この問題は LiveSub 固有のものではありません。 ブラウザでローカルモデルを動かすサービスには、端末差・文の長さ・大きな取得・止められない画面が構造的に付いてきます。 翻訳でなくても、要約や音声認識でも、入力の長さに時間が比例し、端末の速さが訪問ごとに違うのは同じです。
ここで示した組み立ては、次の順で使えます。
- 測る。処理の時間が何に比例するかと、端末ごとの速さを、本番の数字で持つ
- 比例する量で割る。一律の時間を、見積もった量 × 端末の単価に置き換える
- 端末で較正する。係数を全端末一律にせず、読み込み直後の実測から訪問ごとに決める
- 戻る道を付ける。やめる判定には、必ず試して戻る判定を対にする。試しは裏で行い、試す合図は負荷の谷で出し、試す回数には上限を置く
6. まとめ
判定は「時間で切る」から、「比例する量で割り、端末で較正し、戻る道を付ける」へ変えました。 どれも、ブラウザでのライブ配信という条件に合わせた組み立てです。
直す前の判定は、設定の誤りではありませんでした。 一律 1 秒と 3 文という数字は、短い文と速い端末では妥当でした。 問題は、その数字が測っているものが「端末の遅さ」ではなく「文の長さ」だったことです。 判定が厳しいと感じたとき、閾値を緩める前に、閾値が何を測っているかを確かめる。 これが、この直しでいちばん大きな教訓でした。
もう 1 つの教訓は、やめる判定には戻る道を対にすることです。 自動で切り替える仕組みは、切り替えたあとに戻れないと、1 回の山で残りの時間すべてを失います。 戻る道は、サーキットブレーカーの半開の状態を、字幕を止めない形に置き直すだけで作れました。
数字は LiveSub の本番のものです。 係数(原文の字数から訳の語数への換算率・倍率 s・k・m・予備の合図の間隔・既定の端末基準)の決め方は、各サービスが自分の利用者で測るものです。 この記事の形をまねても、数字は自分の端末と利用者で測り直すしかありません。 それでよいと考えています。測る項目と、式の形と、戻る道の置き方が共有できれば、同じ壁にぶつかった人が同じ所から始めなくて済むからです。
このあとの数字も、たまり次第この記事に足します。
Built with PLaMo。この記事のローカル翻訳には、株式会社Preferred Networks の PLaMo 3 Translate 0.8B を使っています。ライセンスは PLaMo コミュニティライセンス契約(英語の文は こちら)です。
この記事について: LiveSub の運営者が書いています。手順・ボタン名・数値は、更新日の時点の LiveSub の画面と照らし合わせて確かめています。違っている点があれば、お問い合わせからお知らせください。